


Co dzieje się z danymi ticketów przy AI w Service Desk?
AI coraz szybciej staje się standardowym elementem systemów Service Desk i ITSM. Podsumowuje długie historie zgłoszeń, sugeruje odpowiedzi, klasyfikuje tickety, pomaga wyszukiwać podobne przypadki i wspiera agentów w podejmowaniu kolejnych działań.
Samo pytanie „czy system ma AI?” zaczyna więc mieć coraz mniejszą wartość.
Znacznie ważniejsze jest inne:
co dokładnie dzieje się z danymi zgłoszenia, kiedy zaczyna je analizować model AI?
Badanie State of Agentic AI in ITSM 2026 przeprowadzone przez ITSM.tools pokazało, że wykorzystanie AI w ITSM jest już powszechne, ale wraz z nim rośnie znaczenie takich kwestii jak jakość danych, governance, ryzyko i compliance.
To dobrze pokazuje zmianę, która zachodzi na rynku.
Dyskusja przestaje dotyczyć wyłącznie tego, co AI potrafi. Coraz częściej dotyczy również tego, na jakich danych pracuje, gdzie działa i kto kontroluje cały proces.
Ticket to nie tylko kilka zdań opisu
Na pierwszy rzut oka może się wydawać, że model AI analizuje tylko tekst wpisany przez użytkownika w polu „Opis”.
W praktyce zakres danych może być znacznie szerszy.
W zależności od systemu i konkretnej funkcji AI model może otrzymywać treść zgłoszenia, jego tytuł, historię komunikacji, komentarze agentów, informacje o użytkowniku, kategorię, priorytet, status, dane dotyczące powiązanego zasobu, wpisy z bazy wiedzy albo fragmenty dokumentacji.
Jeżeli system wykorzystuje załączniki lub logi jako dodatkowy kontekst, zakres informacji może wzrosnąć jeszcze bardziej.
W ticketach często pojawiają się nazwy systemów wewnętrznych, adresy e-mail, nazwiska pracowników, informacje o urządzeniach, fragmenty logów aplikacji, opisy konfiguracji, identyfikatory, dane dotyczące klientów czy szczegóły incydentów bezpieczeństwa.
Dlatego „wysłanie ticketu do AI” nie zawsze oznacza przesłanie jednego krótkiego zdania.
Może oznaczać przekazanie modelowi znacznie szerszego kontekstu.
I właśnie dlatego przed wdrożeniem funkcji AI warto najpierw ustalić zakres danych, a dopiero później oceniać jakość wygenerowanego podsumowania lub odpowiedzi.
Trzy sposoby, w jakie AI może pracować z danymi Service Desk
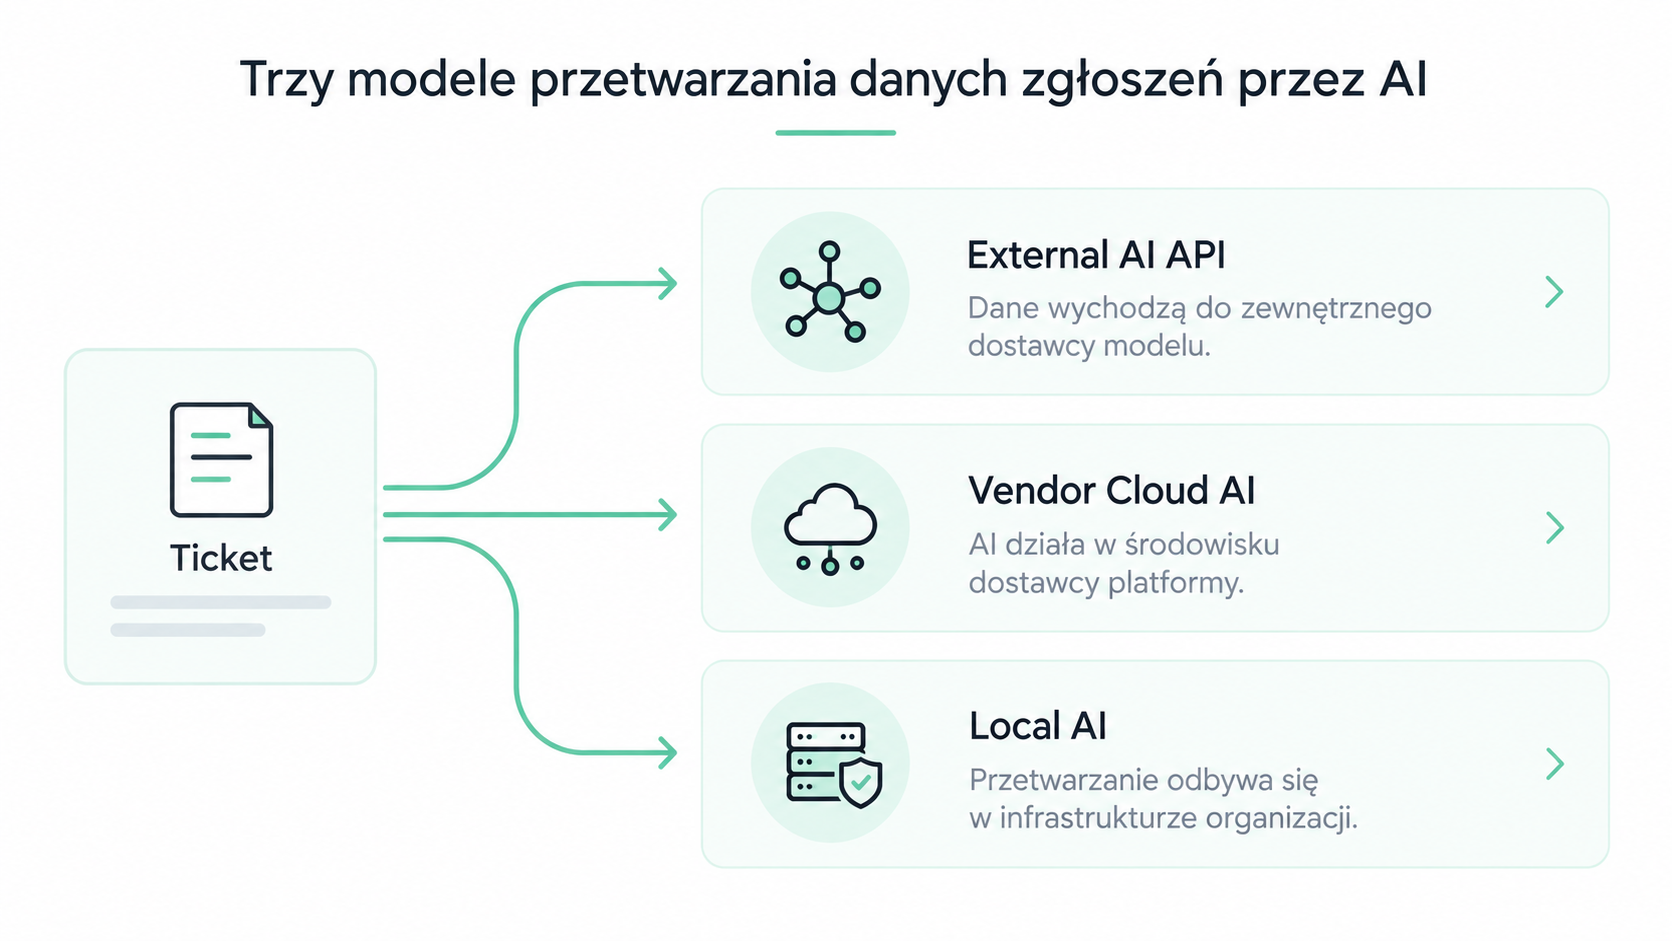
Architektury różnią się między dostawcami, ale z punktu widzenia organizacji można wyróżnić trzy ogólne scenariusze.
1. Zewnętrzne API AI
W pierwszym modelu system Service Desk przekazuje wybrane informacje do zewnętrznego dostawcy modelu AI przez API.
Przykładowy przepływ może wyglądać następująco:
ticket powstaje w systemie ITSM → system przygotowuje prompt i kontekst → dane są przesyłane do zewnętrznej usługi AI → model generuje odpowiedź → wynik wraca do Service Desk.
Z technicznego punktu widzenia jest to wygodne rozwiązanie. Dostawca systemu nie musi utrzymywać własnej infrastruktury modelu, a klient może szybko uzyskać dostęp do nowych możliwości generatywnej AI.
Jednocześnie część danych opuszcza środowisko aplikacji i trafia do kolejnego podmiotu.
Nie musi to automatycznie oznaczać problemu z bezpieczeństwem czy compliance. Wiele usług AI oferuje warianty biznesowe z odpowiednimi warunkami przetwarzania, kontrolą retencji i zasadami dotyczącymi wykorzystania danych.
Ale tego nie należy zakładać.
Trzeba to sprawdzić.
2. AI działające w środowisku dostawcy ITSM
Drugi wariant może wyglądać inaczej z perspektywy użytkownika, ale podobnie z punktu widzenia kontroli nad danymi.
AI jest częścią platformy SaaS, a przetwarzanie odbywa się w środowisku dostawcy ITSM.
Organizacja nie wywołuje bezpośrednio zewnętrznego API i często nawet nie musi wiedzieć, który konkretnie model znajduje się pod spodem. Cały mechanizm jest elementem usługi.
To upraszcza wdrożenie, ale tworzy kolejne pytania.
Czy model jest hostowany bezpośrednio przez dostawcę ITSM? Czy wykorzystywany jest podprocesor? W jakim regionie odbywa się przetwarzanie? Jakie dane są przekazywane do warstwy AI? Jak długo są przechowywane? Czy logi generowane przez usługę zawierają treść zgłoszeń?
Samo określenie „AI jest wbudowane w platformę” nie odpowiada na te pytania.
3. AI działające lokalnie
Trzeci model to AI działające w kontrolowanej infrastrukturze organizacji.
Model może być uruchomiony razem z systemem On-Premises albo w wydzielonym środowisku, nad którym organizacja zachowuje kontrolę.
W takim wariancie ticket nie musi być przesyłany do zewnętrznego dostawcy modelu po to, aby wygenerować podsumowanie lub sugestię odpowiedzi.
Ma to szczególne znaczenie dla organizacji, które mają restrykcyjne polityki dotyczące przepływu informacji, działają w zamkniętych sieciach albo po prostu nie chcą, aby dane Service Desk były przetwarzane poza kontrolowanym środowiskiem.
Nie oznacza to jednak, że „lokalne” automatycznie rozwiązuje każde zagadnienie bezpieczeństwa.
Nadal trzeba wiedzieć, jakie dane dostaje model, kto ma do niego dostęp, jak wygląda logowanie operacji, aktualizacja komponentów, kontrola uprawnień i utrzymanie infrastruktury.
Różnica polega przede wszystkim na miejscu przetwarzania i poziomie kontroli nad nim.
„Czy model uczy się na naszych danych?” to inne pytanie niż „gdzie działa model?”
Te dwa zagadnienia są często wrzucane do jednego worka.
Nie powinny.
Model może działać poza organizacją, a dostawca może jednocześnie zobowiązywać się, że danych klienta nie wykorzystuje do trenowania modeli.
Możliwy jest również system, który przetwarza dane lokalnie, ale zapisuje określone logi albo wykorzystuje informacje do lokalnego mechanizmu wyszukiwania.
Dlatego pytanie:
„Czy nasze dane są wykorzystywane do trenowania AI?”
nie zastępuje pytania:
„Gdzie nasze dane są przetwarzane?”
I odwrotnie.
Przy ocenie architektury AI warto osobno analizować przynajmniej trzy warstwy: miejsce przetwarzania, retencję danych oraz sposób ich późniejszego wykorzystania.
To szczególnie ważne w Service Desk, ponieważ dane trafiające do modelu nie zawsze są oczywiste dla osoby, która tylko klika przycisk „Podsumuj zgłoszenie”.
Im więcej kontekstu dostaje AI, tym ważniejsze staje się zarządzanie danymi
Modele AI potrzebują kontekstu, żeby generować użyteczne odpowiedzi.
Podsumowanie ostatniej wiadomości nie wymaga wielu danych. Sugestia rozwiązania z uwzględnieniem wcześniejszych podobnych zgłoszeń, dokumentacji i bazy wiedzy już tak.
To tworzy ciekawy paradoks.
Im bardziej inteligentna i kontekstowa ma być funkcja AI, tym więcej informacji system może potrzebować, żeby działała dobrze.
Jednocześnie rośnie znaczenie jakości danych, uprawnień i kontroli nad źródłami, do których AI ma dostęp.
Właśnie dlatego raport State of Agentic AI in ITSM 2026 zwraca uwagę nie tylko na możliwości technologii, ale również na bariery związane z danymi, governance i compliance.
Dla zespołów wdrażających AI w ITSM to istotny sygnał.
Problemem nie jest już wyłącznie jakość samego modelu.
Problemem staje się również środowisko informacyjne, które ten model dostaje.
AI Act: przejrzystość jest kolejną warstwą, nie odpowiedzią na pytanie o dane
Od 2 sierpnia 2026 r. zastosowanie mają obowiązki dotyczące przejrzystości określone w art. 50 unijnego AI Act.
Więcej informacji można znaleźć w oficjalnych wytycznych Komisji Europejskiej dotyczących obowiązków przejrzystości w AI Act.
Jednym z zagadnień regulowanych przez art. 50 jest zapewnienie, aby osoba korzystająca z systemu przeznaczonego do bezpośredniej interakcji z człowiekiem wiedziała, że komunikuje się z AI, chyba że jest to oczywiste w danych okolicznościach. Pełny tekst AI Act jest dostępny w EUR-Lex.
To istotne rozróżnienie.
Jeżeli AI działa wyłącznie jako wewnętrzny asystent agenta, na przykład przygotowuje streszczenie istniejącego ticketu, sytuacja jest inna niż w przypadku chatbota, który bezpośrednio odpowiada użytkownikowi portalu.
Artykuł 50 nie oznacza więc prostego:
„każda funkcja AI w Service Desk musi mieć etykietę AI”.
Zakres obowiązków zależy od sposobu wykorzystania systemu.
W 2026 r. wprowadzono również zmiany regulacyjne związane z harmonogramem wdrażania części obowiązków AI Act. Ich szczegóły warto zawsze sprawdzać bezpośrednio w aktualnym tekście prawa i materiałach Komisji Europejskiej.
Dla zespołu wybierającego Service Desk wniosek jest prosty:
regulacje dotyczące przejrzystości nie zastępują analizy architektury danych.
Informacja „rozmawiasz z AI” mówi użytkownikowi, kto generuje odpowiedź.
Nie mówi jeszcze, gdzie trafiły dane potrzebne do jej wygenerowania.
Pięć pytań, które warto zadać dostawcy AI w Service Desk
Przed uruchomieniem AI na rzeczywistych zgłoszeniach warto uzyskać konkretne odpowiedzi na pięć pytań:
- Jakie dokładnie dane są przekazywane do AI? Czy jest to wyłącznie treść bieżącego ticketu, czy również historia, dane użytkownika, załączniki, baza wiedzy i wcześniejsze zgłoszenia?
- Gdzie odbywa się przetwarzanie? Czy model działa u zewnętrznego dostawcy, w środowisku producenta systemu ITSM czy we własnej infrastrukturze organizacji?
- Czy dane są przechowywane po wykonaniu zapytania? Jeśli tak, gdzie, jak długo i w jakim celu?
- Czy dane klienta są wykorzystywane do trenowania lub ulepszania modeli? Odpowiedź powinna wynikać z dokumentacji i umowy, a nie z założenia.
- Czy AI może działać lokalnie i które funkcje rzeczywiście tego dotyczą? „On-Premises” powinno oznaczać konkretną architekturę, a nie tylko lokalne przechowywanie ticketów przy zewnętrznym przetwarzaniu AI.
To dobry punkt wyjścia zarówno do rozmowy z dostawcą, jak i do przygotowania RFP lub Proof of Concept.
PoC powinien sprawdzać przepływ danych, a nie tylko jakość odpowiedzi
Typowy test AI wygląda prosto: wrzucamy kilka ticketów, sprawdzamy wygenerowane podsumowania i oceniamy, czy są trafne.
To za mało.
Dobry PoC powinien pokazać również, skąd AI pobiera kontekst i dokąd ten kontekst trafia.
Warto użyć przykładowych zgłoszeń z różną zawartością: krótkiego incydentu, długiego wątku z historią komunikacji, ticketu z powiązanym zasobem, zgłoszenia zawierającego logi i przypadku, w którym system nie powinien mieć dostępu do określonych informacji.
Pozwala to sprawdzić nie tylko jakość modelu, ale również działanie mechanizmu uprawnień.
Jeżeli agent nie ma dostępu do określonej dokumentacji, AI również nie powinno obchodzić tego ograniczenia tylko dlatego, że potrzebuje dodatkowego kontekstu.
To jeden z obszarów, który wraz z rozwojem Agentic AI będzie coraz ważniejszy.
Jak wygląda to w Mint Service Desk?
W Mint Service Desk przyjęliśmy model lokalnego AI dla środowiska On-Premises.
Moduł działa na infrastrukturze klienta i nie wymaga przesyłania danych zgłoszeń do zewnętrznych usług chmurowych. W obecnym zakresie AI może generować podsumowania ticketów oraz sugerować odpowiedzi agentom. Moduł jest dostępny jako osobno licencjonowany, płatny dodatek.
Jest to spójne z architekturą wersji On-Premises Mint Service Desk, w której instalacja działa na serwerach klienta, a dane pozostają w organizacji.
Więcej informacji znajduje się na stronie AI On-Premises w Mint Service Desk.
Jeżeli chcesz najpierw porównać modele wdrożenia, zobacz również Mint Service Desk On-Premises.
To nie oznacza, że lokalne AI jest właściwą odpowiedzią dla każdej organizacji.
Dla wielu firm wygoda gotowej usługi SaaS będzie ważniejsza niż pełna kontrola infrastruktury. Dla innych wymagania bezpieczeństwa, polityki wewnętrzne lub architektura środowiska sprawią, że zewnętrzne przetwarzanie danych nie będzie akceptowalne.
Dlatego decyzja nie powinna zaczynać się od hasła „Cloud vs On-Premises”.
Powinna zaczynać się od odpowiedzi na pytanie: jakiego poziomu kontroli nad danymi naprawdę potrzebujemy?
Bezpieczne AI w Service Desk? Pokażemy, jak działa lokalnie
24 września podczas webinaru „Bezpieczne AI!? Jak wykorzystać AI w Service Desk bez udostępniania danych na zewnątrz” pokażemy lokalny moduł AI Mint Service Desk od strony praktycznej i technicznej.
Omówimy m.in. różnice pomiędzy AI działającym w chmurze i lokalnie, przepływ danych z ticketów, zastosowania AI w pracy agenta oraz sposób działania lokalnego modułu.
24.09.2026 | 13:00 | online
Zapisz się bezpłatnie na webinar
Nie pytaj tylko, co potrafi AI. Zapytaj, gdzie działa.
AI może realnie odciążyć Service Desk.
Może skrócić czas potrzebny na zapoznanie się z historią zgłoszenia, pomóc agentowi znaleźć właściwą odpowiedź i ograniczyć część powtarzalnej pracy.
Ale wraz z rosnącymi możliwościami AI rośnie również ilość kontekstu, którego potrzebuje model.
Dlatego ocena rozwiązania nie powinna kończyć się na jakości wygenerowanej odpowiedzi.
Trzeba również wiedzieć, jakie dane otrzymał model, gdzie zostały przetworzone, jak długo są przechowywane i kto kontroluje środowisko, w którym odbywa się analiza.
W praktyce właśnie te pytania mogą okazać się ważniejsze niż kolejna funkcja oznaczona w cenniku ikoną „AI”.
FAQ: AI w Service Desk a bezpieczeństwo danych
Czy AI w Service Desk zawsze wysyła dane do zewnętrznego modelu?
Nie. Zależy to od architektury konkretnego rozwiązania. AI może korzystać z zewnętrznego API, działać w środowisku chmurowym dostawcy ITSM albo być uruchomione lokalnie. Dlatego przed wdrożeniem należy sprawdzić faktyczny przepływ danych, a nie zakładać go na podstawie samej nazwy funkcji.
Jakie dane z ticketu może analizować AI?
Zakres zależy od konkretnej funkcji i konfiguracji systemu. Może obejmować treść i tytuł zgłoszenia, historię komunikacji, informacje o użytkowniku, bazę wiedzy, wcześniejsze przypadki, logi lub inne dane przekazywane modelowi jako kontekst. Dostawca powinien jasno określić, które informacje są wykorzystywane.
Czy lokalne AI jest bezpieczniejsze od AI w chmurze?
Samo miejsce uruchomienia modelu nie wystarcza do kompleksowej oceny bezpieczeństwa. Lokalne AI może zwiększyć kontrolę nad przepływem danych i ograniczyć potrzebę przesyłania informacji do zewnętrznego dostawcy, ale nadal wymaga odpowiedniego zarządzania dostępem, infrastrukturą, aktualizacjami i logami.
Czy AI Act wymaga informowania użytkownika, że rozmawia z AI?
Od 2 sierpnia 2026 r. art. 50 AI Act wprowadza obowiązki przejrzystości dla określonych systemów AI. W przypadku systemów przeznaczonych do bezpośredniej interakcji z osobami fizycznymi użytkownik powinien zostać poinformowany, że prowadzi interakcję z AI, chyba że jest to oczywiste w danych okolicznościach.
Aktualne informacje można sprawdzić w materiałach Komisji Europejskiej dotyczących art. 50 AI Act oraz w pełnym tekście AI Act w EUR-Lex.


